llms.txt im Praxistest: Was die Datei für Ihre KI-Sichtbarkeit bringt
llms.txt im Praxistest: Was die Datei für Ihre KI-Sichtbarkeit bringt
Seit Monaten gilt die llms.txt als Pflichtübung für alle, die in ChatGPT, Perplexity oder Googles KI-Antworten auftauchen wollen. Eine kleine Textdatei im Hauptverzeichnis, und die KI versteht Ihre Website – so lautet das Versprechen. Wir haben geprüft, was Studien, die Anbieter selbst und unsere eigenen Logfiles dazu sagen. Das Ergebnis ist ernüchternd, aber kein Grund, die Datei zu löschen.
Was ist die llms.txt?
Die llms.txt ist eine Textdatei im Markdown-Format, die im Hauptverzeichnis einer Website liegt – erreichbar unter ihre-domain.de/llms.txt. Sie soll Sprachmodellen (Large Language Models) eine kompakte, kuratierte Übersicht der wichtigsten Inhalte geben: ohne Navigation, Werbung und Skripte, die das Auslesen von HTML erschweren.
Vorgeschlagen hat das Format der Entwickler Jeremy Howard (Answer.AI) am 3. September 2024; die Spezifikation steht auf llmstxt.org. Für die Einordnung ist ein Punkt wichtig: Es handelt sich um einen Vorschlag aus der Entwickler-Community, nicht um einen verabschiedeten Standard. Kein KI-Anbieter hat sich verpflichtet, die Datei zu lesen.
So ist eine llms.txt aufgebaut (mit Beispiel)
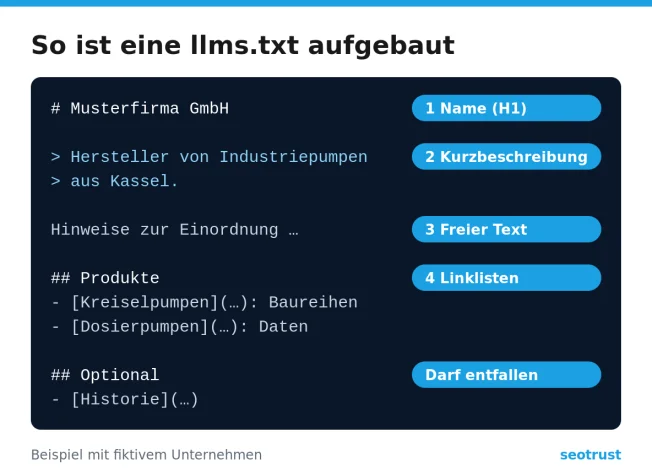
Die Spezifikation sieht vier Bausteine vor:
- Überschrift (H1) – der Name des Unternehmens oder Projekts. Nur dieser Teil ist Pflicht.
- Kurzbeschreibung als Blockzitat – eine knappe Zusammenfassung des Angebots.
- Freier Text – Hinweise, wie die folgenden Inhalte einzuordnen sind.
- Abschnitte mit Linklisten – die wichtigsten Seiten, jeweils mit kurzer Erläuterung. Ein Abschnitt „Optional“ kennzeichnet Inhalte, die bei knappem Kontext entfallen dürfen.
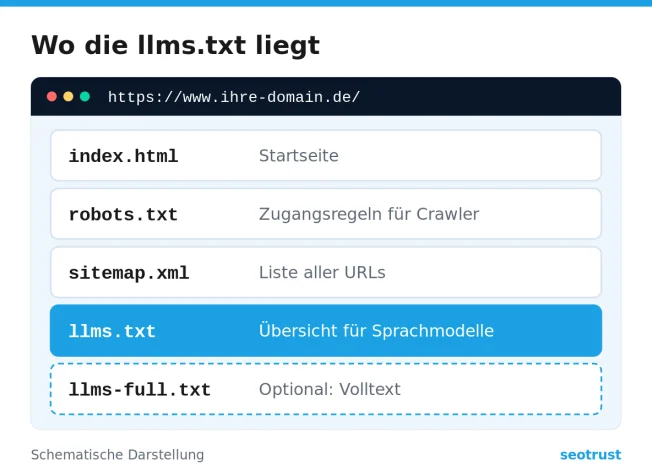
Häufig kommt eine zweite Datei hinzu: die llms-full.txt mit den wichtigsten Inhalten im Volltext. Sie ist nicht Teil der Spezifikation, hat sich aber vor allem bei technischen Dokumentationen etabliert.
llms.txt erstellen: in vier Schritten
Wer die Datei anlegen möchte, braucht dafür kein Tool. Vier Schritte genügen:
- Seiten auswählen – die Seiten, die Ihr Angebot am besten erklären: Leistungen, Produkte, Preise, Kontakt und zentrale Ratgeber.
- Markdown schreiben – Name, Kurzbeschreibung und Linklisten nach dem Aufbau oben. Jede Zeile sagt in wenigen Worten, was die verlinkte Seite enthält.
- Ins Hauptverzeichnis legen – als reine Textdatei unter /llms.txt, kodiert in UTF-8.
- Abruf prüfen – die Datei muss ohne Anmeldung und ohne Weiterleitung erreichbar sein.
Für gängige Content-Management-Systeme gibt es Plugins und Generatoren, die die Datei automatisch erzeugen. Prüfen Sie das Ergebnis trotzdem von Hand: Eine automatisch befüllte Liste aller URLs ist keine kuratierte Übersicht. Für eine mittelgroße Unternehmensseite sollten Sie ein bis zwei Stunden einplanen. Unsere eigene Datei finden Sie unter seotrust.de/llms.txt.
Was Google und die KI-Anbieter dazu sagen
Google hat sich klar positioniert. Gary Illyes erklärte im Juli 2025 auf der Search Central Live Deep Dive Asia Pacific, dass Google die llms.txt nicht unterstützt und das auch nicht plant. Sein Kollege John Mueller hatte die Datei schon im April 2025 mit dem Meta-Keywords-Tag verglichen: eine Selbstauskunft des Betreibers, die man ebenso gut an der Website selbst überprüfen könne.
Seit 2026 steht das auch in Googles Leitfaden zur Optimierung für KI-Funktionen: Solche Dateien sind für die Suche nicht nötig, sie schaden und nützen dort nicht. Für die AI Overviews und den Google AI Mode spielt die llms.txt damit keine Rolle. Dass Chrome Lighthouse die Datei inzwischen in der Kategorie „Agentic Browsing“ prüft, betrifft KI-Agenten – nicht das Ranking.
Auch OpenAI, Anthropic und Perplexity haben bisher nicht öffentlich bestätigt, dass sie die llms.txt für ihre Suchantworten auswerten. Zur Steuerung ihrer Bots verweisen sie auf die robots.txt.
Was die Studien zeigen: kein messbarer Effekt auf Zitierungen
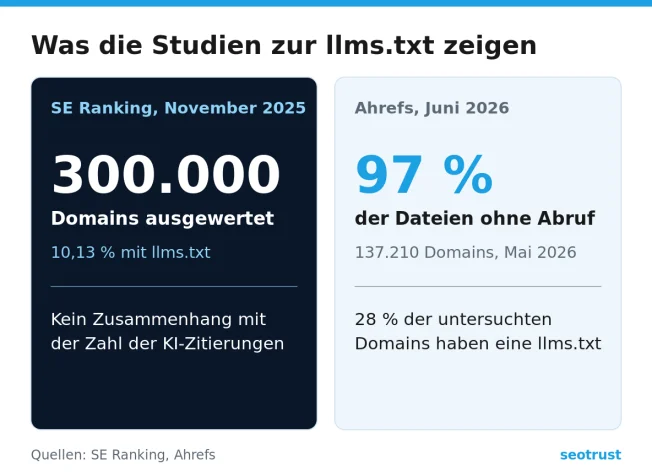
Der Tool-Anbieter SE Ranking hat im November 2025 rund 300.000 Domains ausgewertet. Etwa jede zehnte (10,13 %) hatte eine llms.txt. Ein Zusammenhang mit der Häufigkeit, mit der eine Domain in KI-Antworten zitiert wird, ließ sich nicht nachweisen – weder in Korrelationstests noch in einem Machine-Learning-Modell. Das Modell wurde sogar genauer, nachdem die Analysten das Merkmal llms.txt entfernt hatten (Bericht im Search Engine Journal).
Ahrefs hat im Juni 2026 untersucht, ob die Dateien überhaupt gelesen werden. Von 137.210 Domains hatten 28 % eine llms.txt. 97 % dieser Dateien wurden im Mai 2026 kein einziges Mal abgerufen – weder von Bots noch von Menschen (Ahrefs-Studie). Verbreitet ist die Datei inzwischen durchaus. Einen messbaren Effekt auf Zitierungen hat bisher niemand belegt.
Der Blick in unsere eigenen Logfiles
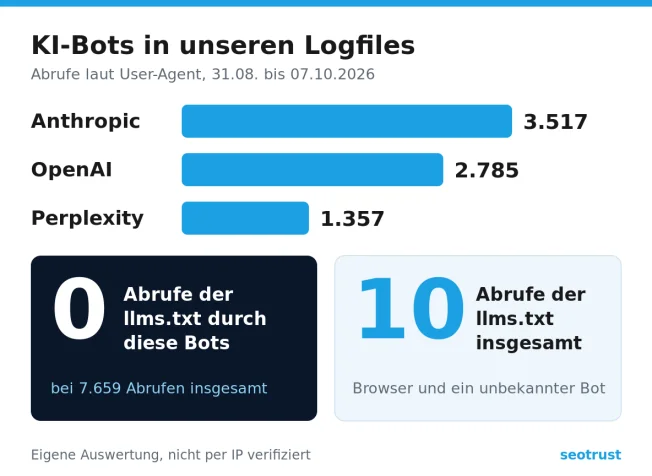
Wir haben nachgezählt. Vom 31. August bis zum 7. Oktober 2026 verzeichnen die Logfiles unseres Webservers 7.659 Abrufe, die sich per User-Agent als Crawler und Abruf-Bots von Anthropic, OpenAI und Perplexity ausweisen – darunter ClaudeBot, GPTBot, OAI-SearchBot und PerplexityBot. Kein einziger dieser Abrufe galt der llms.txt.
Abgerufen wurde die Datei im selben Zeitraum trotzdem: zehnmal, von gewöhnlichen Browsern und einem uns unbekannten Bot. Auf unserem Server lasen die KI-Bots stattdessen das, was auch Menschen sehen – die HTML-Seiten.
Zwei Einschränkungen gehören dazu: User-Agents lassen sich fälschen, und ein einzelner Server ersetzt keine Studie. Die Zahlen passen aber zum Befund von Ahrefs.
Wo die llms.txt trotzdem sinnvoll ist
Wertlos ist die Datei deshalb nicht. Sie hat ihren Platz dort, wo Menschen oder Programme sie gezielt an ein Sprachmodell übergeben:
- Technische Dokumentation und APIs – Coding-Assistenten verarbeiten Markdown deutlich sparsamer als HTML. Bei Softwareanbietern ist eine llms.txt für die Dokumentation inzwischen verbreitet.
- KI-Agenten und eigene Chatbots – wer Inhalte in ein eigenes Assistenzsystem einspeist, hat mit der llms-full.txt eine saubere Quelle.
- Klarheit über das eigene Angebot – die Datei zwingt dazu, Leistungen und Zuständigkeiten in wenigen Sätzen korrekt zu beschreiben. Das hilft auch an anderer Stelle.
Hinzu kommt: Die Datei kostet wenig und schadet nicht. Sollte ein Anbieter sie künftig auswerten, sind Sie vorbereitet.
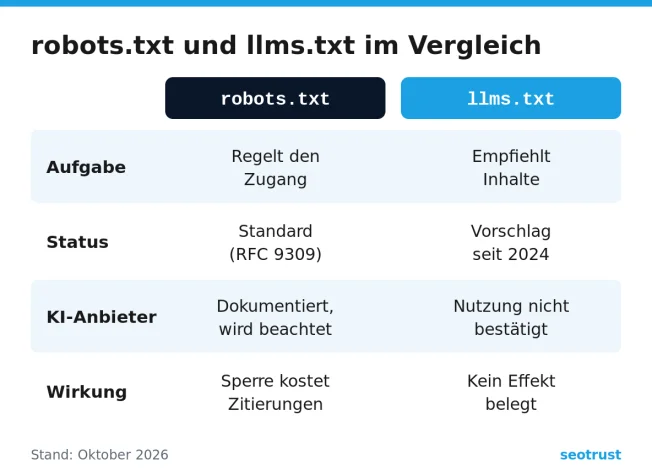
llms.txt oder robots.txt – wo ist der Unterschied?
Beide Dateien liegen im Hauptverzeichnis, erfüllen aber verschiedene Aufgaben. Die robots.txt regelt den Zugang: Sie legt fest, welche Crawler welche Bereiche abrufen dürfen. Nach Angaben der Anbieter halten sich GPTBot, ClaudeBot und PerplexityBot daran. Die llms.txt regelt nichts – sie empfiehlt Inhalte.
Für Ihre KI-Sichtbarkeit ist die robots.txt deshalb die wichtigere Datei. Wer dort die Such-Bots der KI-Anbieter aussperrt, wird in deren Suchantworten in der Regel nicht mehr als Quelle herangezogen. Nutzerausgelöste Abrufe wie ChatGPT-User oder Perplexity-User behandeln die Anbieter teils anders.
Solche Sperren entstehen oft unbemerkt, etwa durch eine pauschale Regel oder eine Firewall-Einstellung. Die Prüfung gehört deshalb an den Anfang jeder KI-Optimierung – für Googles KI-Antworten ebenso wie für Perplexity.
Was wirklich über Ihre KI-Sichtbarkeit entscheidet
Wenn die llms.txt kein Hebel ist – was dann? Diese fünf Punkte bestimmen, ob KI-Systeme Ihre Inhalte finden und zitieren:
- Crawlbarkeit – Inhalte sollten im ausgelieferten HTML stehen, denn die meisten KI-Crawler führen kein JavaScript aus.
- Autorität – nachvollziehbare Autoren, Markennennungen und Verlinkungen aus seriösen Quellen. Mehr dazu im Beitrag zu E-E-A-T für KI.
- Strukturierte Daten – Schema Markup liefert den Kontext maschinenlesbar mit.
- Zitierfähige Inhalte – klare Aussagen, eigene Daten und direkte Antworten am Anfang eines Abschnitts.
- Messung – wer nicht prüft, in welchen Antworten die eigene Marke vorkommt, optimiert im Blindflug.
Das ist der Kern von KI-SEO und Generative Engine Optimization. Beides baut auf sauberem SEO auf und ersetzt es nicht.
Fazit: Hygiene ja, Hebel nein
Die llms.txt ist schnell erstellt und in einzelnen Szenarien nützlich. Ein Hebel für Ihre Sichtbarkeit in ChatGPT, Perplexity oder Googles KI-Antworten ist sie nach heutigem Stand nicht. Wer sie anlegt, sollte das wissen – und das Budget dort einsetzen, wo es nachweislich wirkt: bei Technik, Inhalten und Autorität.
Als SEO- und KI-Agentur prüfen wir für Sie, wo Ihre Website in der KI-Suche heute steht und welche Maßnahmen sich lohnen.
Wie sichtbar ist Ihre Marke in KI-Antworten?
Wir prüfen, ob KI-Crawler Ihre Website erreichen, in welchen Antworten Sie heute vorkommen und welche Maßnahmen sich für Sie lohnen. Sprechen Sie mit uns.
Jetzt KI-Sichtbarkeit prüfenÜber seotrust
SEOTRUST ist eine spezialisierte Agentur für SEO, KI-Sichtbarkeit und digitale Wachstumsstrategien aus Frankfurt am Main. Seit mehr als 20 Jahren begleiten wir mittelständische Unternehmen, Marken und Konzernumfelder bei technischer SEO, Content-Strategie, GEO, AI Visibility und nachhaltigem organischem Wachstum.
Navigation
Letzte News
Kontakt
-
- Anschrift
- Zeil 46, 60313 Frankfurt am Main
- Telefon
- hallo@seotrust.eu
-
- Öffnungszeiten
- Mo-Fr: 09:00 - 18:00 Uhr